2. November 2026
Erkennt meine Hochschule, dass ich ChatGPT benutzt habe?
Wenn du das eine Woche vor der Abgabe suchst, steckt meist nicht die Sorge dahinter, betrogen zu haben, sondern die, an einer vernünftigen Stelle ein KI-Tool benutzt zu haben (einen Absatz glätten, im Methodenteil wieder in Gang kommen, eine Quelle übersetzen), ohne dass dir jemand klar gesagt hat, ob das ein Problem ist.
Hier die klare Fassung, mit Zahlen und Herkunft. Sie sagt dir nicht, wie du einer Erkennung entgehst; dieser Rat schadet dir. Sie sagt dir, was die Systeme tun, was sie falsch machen und was Studierenden wirklich Ärger einbringt, und das ist nicht das, was die meisten befürchten.
Zuerst: Bei einer deutschsprachigen Arbeit greift die Erkennung gar nicht
Die KI-Erkennung von Turnitin unterstützt kein Deutsch. Die Sprachliste umfasst Englisch, Spanisch und Japanisch; für eine deutschsprachige Arbeit entsteht schlicht kein KI-Bericht.
Das ist der Stand des Felds, und er gilt auch für uns: Unsere KI-Textprüfung läuft nur bei englischsprachigen Arbeiten, weil es zu wenig belastbare Evidenz gibt, dass solche Klassifikatoren bei deutscher Wissenschaftsprosa vernünftig arbeiten.
Schreibst du also an einer Schweizer, deutschen oder österreichischen Hochschule auf Deutsch, ist die Antwort auf "Erkennt die Software das?" unspektakulär: Keine Software analysiert deinen deutschen Text auf KI-Autorschaft. Was für dich gilt, ist die Erklärung, die du unterschreibst.
Was die KI-Erkennung von Turnitin überhaupt meldet
Für den Fall, dass du auf Englisch schreibst: Turnitin gibt einen Prozentwert aus, der schätzt, wie viel eines Dokuments wahrscheinlich KI-generiert ist. Er ist unabhängig vom Ähnlichkeitsbericht und braucht mindestens 300 Wörter Fliesstext.
Was Turnitin über sich selbst veröffentlicht, mit den Einschränkungen:
- Unter 1 Prozent Fehlalarme auf Dokumentebene (Stand 2026), aber nur für Dokumente mit 20 Prozent KI oder mehr. Für 1 bis 19 Prozent gibt es keine veröffentlichte Fehlalarmquote.
- Werte von 1 bis 19 Prozent erscheinen als Sternchen, nicht als Zahl, weil die Treffsicherheit dort schlechter ist. Diese Entscheidung sagt etwas aus.
- Rund 4 Prozent Fehlalarme auf Satzebene, aus einem Beitrag von 2023, den die aktuelle Dokumentation nicht mehr nennt.
- Kein Beweis: Turnitin hält fest, es stelle "kein Fehlverhalten fest", und der Wert dürfe nicht die alleinige Grundlage für Massnahmen sein.
Online liest man "Turnitin ist zu 98 Prozent genau". Das vermischt eine 2023 zum Start genannte "98 Prozent Konfidenz" mit der Angabe, dass 98 Prozent der Kundeninstitutionen die Funktion aktiviert hatten. Eine Genauigkeitsangabe veröffentlicht Turnitin heute nicht.
Was die Forschung sagt, auch die unbequemen Teile
Die unabhängige Evidenz ist uneinheitlich, und sie hat sich verschoben:
- 2023, Benachteiligung. Eine Studie in Patterns prüfte sieben Detektoren an 91 TOEFL-Essays von Personen mit anderer Erstsprache als Englisch. Die durchschnittliche Fehlalarmquote lag bei 61 Prozent; fast 98 Prozent der Essays wurden von mindestens einem Detektor markiert. Bei Essays von US-Schülerinnen und -Schülern lagen dieselben Detektoren fast immer richtig: Sie lasen unsicheres Englisch als Maschinentext.
- 2023, Treffsicherheit. Eine Studie im International Journal for Educational Integrity prüfte 14 Werkzeuge, alle unter 80 Prozent Treffsicherheit: "weder genau noch verlässlich". Fairerweise: Für Turnitin verzeichnete sie null Fehlalarme.
- 2026, das Bild hat sich gedreht. Eine IJEI-Studie der Vrije Universiteit Brussel vom Juni 2026 prüfte Turnitin, GPTZero, Copyleaks und Pangram an 160 Arbeiten auf Masterniveau (menschlich, vollständig KI-generiert, gemischt und "humanisiert"):
- null Fehlalarme bei menschlichen Texten für alle vier Werkzeuge;
- aber Turnitin, GPTZero und Copyleaks erkannten nur 0 bis 30 Prozent vollständig KI-generierter Texte, und Turnitin übersah alle 40 vollständig KI-generierten Arbeiten;
- nur Pangram war zuverlässig: 97,5 Prozent bei vollständig KI-generiertem und 92,5 Prozent bei humanisiertem Text;
- an 1'163 echten Masterarbeiten aus 2024/25 markierte Pangram 45,5 Prozent als wahrscheinlich KI-beteiligt, meist nur teilweise.
Die ehrliche Bilanz für 2026 ist für alle unbequem: Die Werkzeuge beschuldigen seltener falsch, aber sie finden das meiste nicht. "Detektoren sind voreingenommen, eine Markierung heisst nichts" stützt sich auf Daten von 2023. Eine Markierung ist nicht bedeutungslos; sie beweist nur allein nichts.
Der Befund, an dem alles hängt: OpenAI zog seinen KI-Text-Klassifikator nach sechs Monaten (Januar bis Juli 2023) "aufgrund seiner niedrigen Treffsicherheit" zurück. Er erkannte 26 Prozent der KI-Texte und markierte 9 Prozent menschlicher Texte falsch. Das Unternehmen hinter ChatGPT konnte ChatGPT nicht zuverlässig erkennen.
Manche Hochschulen haben die Funktion ganz abgeschaltet
- Vanderbilt deaktivierte die KI-Erkennung im August 2023 und hat sie nicht wieder eingeschaltet. Die Begründung war eine Rechnung: 1 Prozent Fehlalarme bei 75'000 Arbeiten pro Jahr ergeben rund 750 zu Unrecht markierte Arbeiten.
- Yale, Michigan State und UC Berkeley haben sie ebenfalls abgeschaltet oder nie aktiviert.
- Die Australian Catholic University gab das Werkzeug im März 2025 auf, nach rund 6'000 Verfahren in einem Jahr, etwa 90 Prozent davon KI-bezogen, von denen rund ein Viertel eingestellt wurde (berichtet im Oktober 2025).
- Die University of Kentucky behielt die Erkennung ohne Abwahlmöglichkeit, wies die Lehrenden aber an, die Werte "mit gesunder Skepsis" zu behandeln.
Verbreitet ist auch die Behauptung, "über 50 Hochschulen hätten KI-Erkennung verboten". Wir fanden keine Primärquelle; jede Variante stammte von Anbietern, die Werkzeuge zum Umgehen von Detektoren verkaufen.
Was Studierenden wirklich Probleme macht
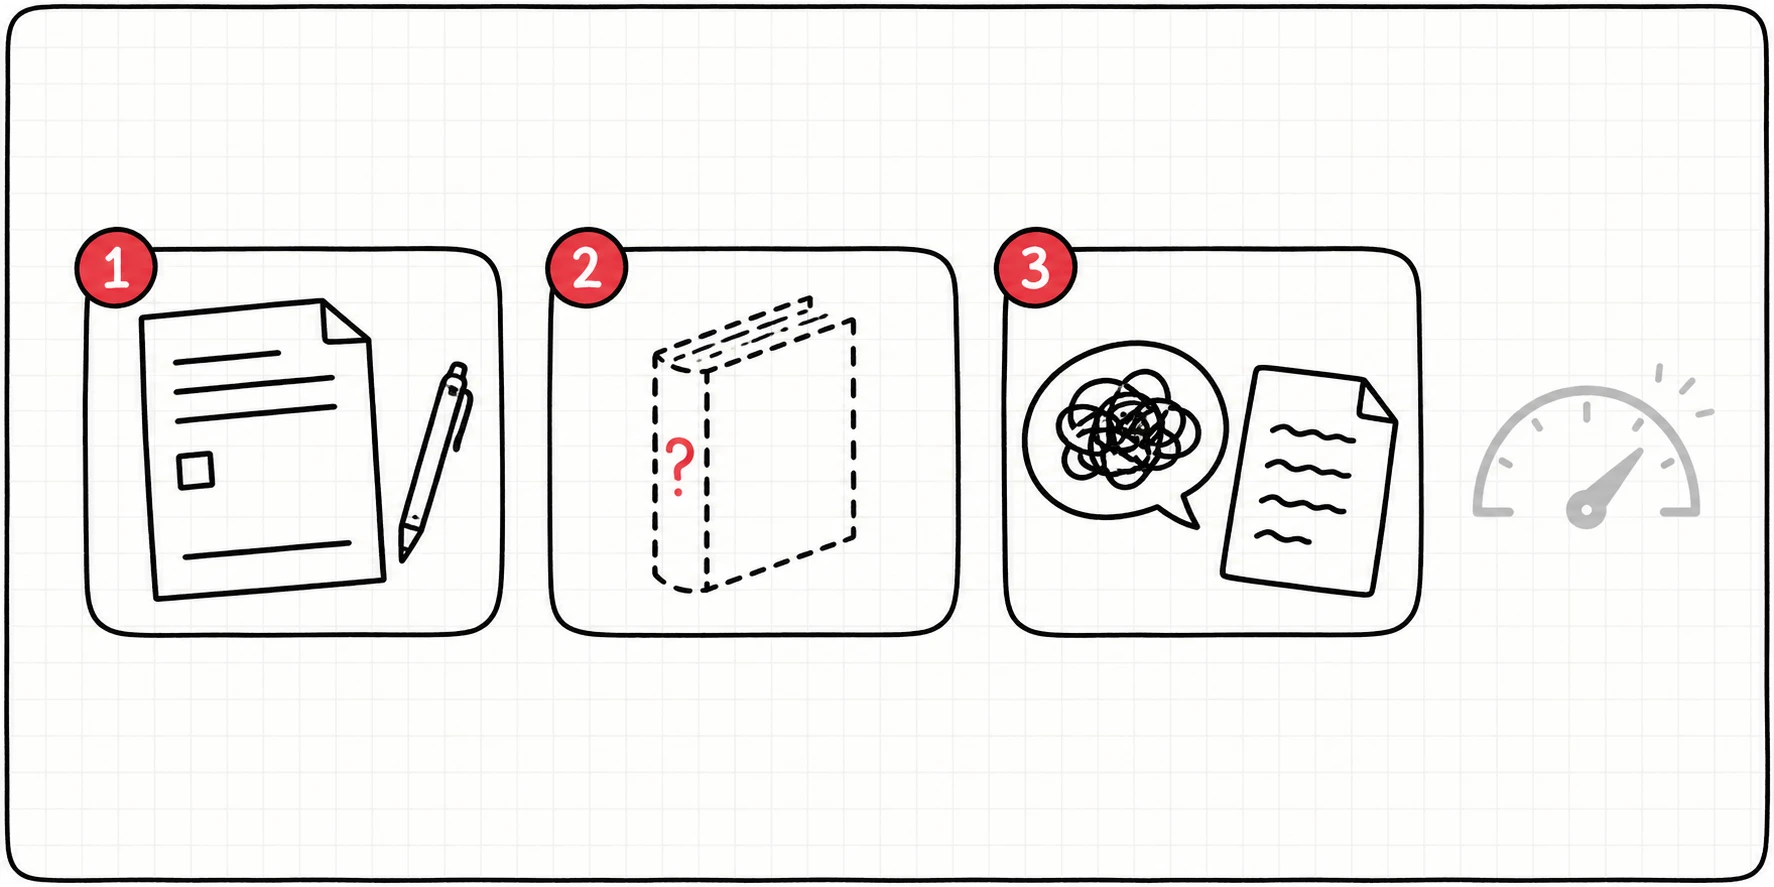
Nicht der Detektor. Drei andere Dinge:
1. Nicht deklarierte Nutzung. Der entscheidende Punkt. Laut ETH Zürich ist die Verwendung von KI-Output für sich kein Plagiat, nicht deklarierte Nutzung aber eine "besondere Form des Ghostwritings", die zu einem Disziplinarverfahren führen kann. Im deutschsprachigen Raum verlangen Hochschulen inzwischen konkrete Erklärungen:
- Universität Vechta: ein Anhang mit jeder KI-Anwendung, Name, Version und Art der Nutzung, vorab mit der prüfenden Person abgestimmt.
- MedUni Wien: eine Hilfsmitteltabelle mit Software, Zweck und Textabschnitt in der eidesstattlichen Erklärung; KI-Werkzeuge zusätzlich im Literaturverzeichnis.
- Medizinische Fakultät der UZH: ein Abschnitt zur KI-Nutzung im Methodenkapitel.
Die Regeln unterscheiden sich je nach Land und Hochschule, teils erheblich; an einer US-Hochschule gibt es womöglich gar keine förmliche Erklärung. Massgeblich ist die aktuelle Vorgabe deiner eigenen Hochschule, nicht dieser Artikel. Sie ist meist eine Seite lang und erlaubt meist mehr, als Studierende annehmen.
Eine gute Erklärung nennt Werkzeug, Version, Zweck und Stelle:
2. Erfundene Quellen. Das fliegt tatsächlich auf. KI-Werkzeuge erfinden echt wirkende Quellen (plausibler Name, Zeitschrift, Jahr), und die ETH verlangt, dass du jede Quelle, jeden Link und jedes Zitat selbst prüfst. Ein Detektor ist dafür nicht nötig: Deine Betreuung schlägt eine bekannte Quelle nach und findet sie nicht.
3. Die eigene Arbeit nicht erklären können. In der Verteidigung braucht niemand Software, um zu merken, dass jemand einen Absatz der eigenen Arbeit nicht erklären kann.
Zu "Humanizer"-Tools
Lass es.
Ob sie technisch etwas bringen, hat ein kurzes Verfallsdatum: Turnitin führte im August 2025 eine Erkennung solcher Werkzeuge ein, und laut der Studie vom Juni 2026 blieben "humanisierte" Texte für das beste Werkzeug erkennbar.
Aber das ist nicht das Argument. Wer seinen Text durch einen Humanizer schickt und die Eigenständigkeitserklärung unterschreibt, gibt eine falsche förmliche Erklärung ab: deutlich schwerwiegender als nicht deklarierte KI-Nutzung, und bewusst, schriftlich, mit Unterschrift.
Klingt dein Text nach KI, tarne ihn nicht. Schreib die Passage selbst neu, bis du jeden Satz erklären kannst. Gelingt dir das nicht, ist sie nicht fertig, egal wer sie geschrieben hat, und genau diesen Test legt auch deine Betreuung an.
Wenn du zu Unrecht beschuldigt wirst
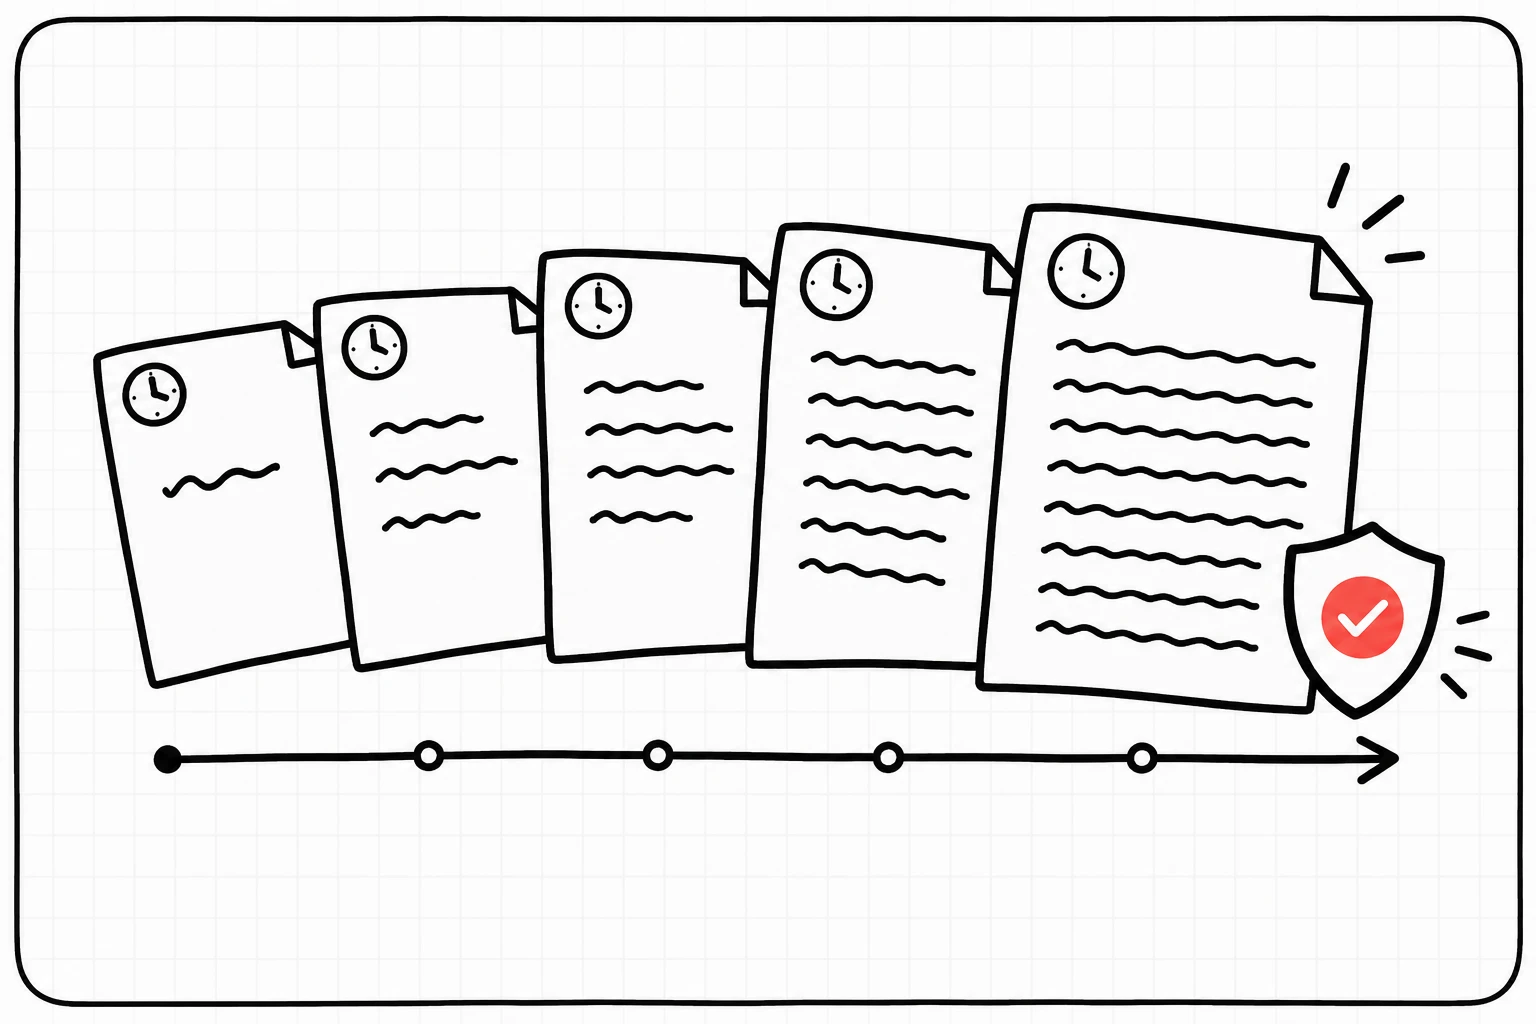
Das kommt vor, und es gibt ein Verfahren. Die britische Ombudsstelle für Hochschulen veröffentlichte im Juli 2025 Leitlinien, die überall beschreiben, wie ein faires Verfahren aussieht:
- Die Beweislast liegt bei der Hochschule: Sie muss beweisen, dass die studierende Person das Vorgeworfene getan hat, nicht die Studierenden das Gegenteil.
- Du hast Anspruch darauf, den Bericht zu sehen, nicht nur eine Zahl zu hören.
- Deine Entwürfe sind Beweismittel. Du solltest Notizen und Entwürfe einreichen und deinen Arbeitsprozess erläutern können.
- Hol dir Unterstützung, etwa über die Studierendenvertretung.
- Detektorergebnisse allein reichen nicht. Die Ombudsstelle gab Beschwerden statt, bei denen Hochschulen sich darauf gestützt hatten, ohne die Entwürfe anzusehen.
Die praktische Regel: Bewahre Entwürfe und Versionsverlauf auf. Schreib in einem Programm, das Versionen speichert (Google Docs, Overleaf, Word mit Änderungsverfolgung oder Git). Das kostet nichts, und ein Verlauf mit Zeitstempeln ist genau das Beweismittel, nach dem das Verfahren fragt.
So nutzt du KI, ohne dass daraus ein Problem wird
Wo PaperCheck hineinpasst und wo nicht
Hier sollten wir in eigener Sache deutlich sein, denn wir haben auch einen Detektor.
Bei englischsprachigen Arbeiten zeigt unser Plagiats- & KI-Check neben den gefundenen Quellen einen KI-Wert mit einer verständlichen Einstufung (von "Kein KI-Signal erkannt" bis "Sehr wahrscheinlich KI-generiert"), eine Ansicht pro Seite und die markierten Sätze. Bei deutschsprachigen Arbeiten läuft er nicht, aus den oben genannten Gründen.
Alles in diesem Artikel gilt für unser Ergebnis genauso wie für das von Turnitin: Der Bericht selbst nennt den Wert "ein wahrscheinliches Signal, kein abschliessendes Urteil". Wir helfen niemandem, eine Erkennung zu umgehen, und uns ist lieber, du überarbeitest eine Passage, weil du sie nicht erklären kannst, als weil ein Klassifikator sie nicht mochte.
Nützlicher finden wir, zu prüfen, was tatsächlich Probleme macht:
- Quellengesundheit gleicht jede Angabe im Literaturverzeichnis mit wissenschaftlichen Datenbanken ab und ordnet sie danach, was zu tun ist (verifiziert, korrigieren oder selbst prüfen), wo möglich mit dem falschen Feld und einem Korrekturvorschlag. Das ist die Kontrolle, die die ETH verlangt, und der schnellste Weg, eine erfundene Quelle vor deiner Betreuung zu finden.
- Feedback zu den Teilen, die deine sein müssen: Argumentation, Stringenz, logische Fehler, Zitierstil und Struktur.
Weiterlesen
- Literaturverzeichnis prüfen
- Wie Schweizer Hochschulen wirklich auf Plagiate prüfen
- Tools für die Abschlussarbeit
Unsicher bei einer Quelle, die du nicht zuordnen kannst? Lade deine Arbeit bei PaperCheck hoch und lass jede Quelle prüfen, zusammen mit vollständigem Feedback zu Argumentation und Struktur.
Quellen und Stand: Turnitins eigene Guides und Blogbeiträge (2023–2026); Liang et al., Patterns (2023); Weber-Wulff et al., IJEI (2023); Perkins et al. (2024); Van Vlasselaer et al., IJEI (Juni 2026); OpenAI (2023); Vanderbilt (2023); ABC News zur Australian Catholic University (Oktober 2025); Casework Note der britischen Hochschul-Ombudsstelle (Juli 2025); Vorgaben von ETH Zürich, Universität Vechta, MedUni Wien und UZH. Stand: September 2026. Die Lage ändert sich schnell. Prüfe die aktuellen Regeln deiner eigenen Hochschule.